Wednesday, September 24, 2014

Java 8'de Torbalar Üzerinde "Paralel Yapılar" Kurulması

   
Verilerin işlenebilmesi için bellekte organize edilmeleri gerekir. Bunun için çeşitli organizasyon biçimleri bulunuyor: Dizi, Bağlantılı Liste, Yığın, Kuyruk. Java'da bu organizasyon biçimlerinin çok daha fazlası Collection API içinde bulunur ve uygulama geliştirilirken pek çoğu kullanılır. Torba seçimi, veriye nasıl ve hangi amaçla erişileceğine bağlıdır. Eğer çoğu zaman rastgele ve daha çok okumak amacıyla, konumuna göre rasgele erişiliyorsa ArrayList, ama rasgele silme/ekleme yapılacak ve daha çok ardışık olarak erişilecekse LinkedList kullanılmalıdır. Eğer çift değerlere izin verilmiyorsa, Set arayüzüne sahip bir torba kullanılmalıdır. Bu noktada, ekleme sırası önemliyse, LinkedHashSet’in, her zaman sıralı erişilecekse TreeSet’in ve daha çok verilerin torbada var olup olmadığı sorgulanacaksa HashSet’in kullanımı uygulama başarımı için tercih edilir. Eğer veriler (Anahtar ve Değer) ikililerinden oluşuyorsa Map arayüzüne sahip bir torbanın kullanılması gerekir. Map verilere anahtar üzerinden erişilmesini sağlar, verilen anahtar için o anahtar değerli değer döndürülür. Eğer anahtarların eklenme sırası önemliyse, LinkedHashMap, her zaman sıralı erişilecekse TreeMap ve daha çok verilerin torbada var olup olmadığı sorgulanacaksa HashMap tercih edilir.  Collection API içinde bunlar dışında pek çok sayıda daha torba bulunur. Java geliştiricilerinden torbaların detaylarını iyi derecede biliyor olması beklenir.
   Torba içindeki verilere ardışık olarak erişim için iki yöntem bulunmaktadır:
1. for-each Kullanımı
for(:) gösterimi Java programlama diline Java SE 5 ile gelmiştir:
List<City> cities;
for (City city: cities){
     System.out.println(city.getName());
}
Burada city değişkeni sırayla cities torbasındaki tüm nesneleri ziyaret eder. for-each gösterimi salt okunurdur, gözlerini ziyaret ettiği torba üzerinde herhangi bir değişikliğe neden olamaz. Torbadaki tüm elemanlar taranır, eleman atlamak mümkün değildir. Eğer torbada değişiklik yapılacak ise Iterator<T> kullanılmalıdır.
2. Iterator<T> Kullanımı
List<City> cities;
Iterator<City> iter= cities.iterator();
while (iter.hasNext()){
    City city= iter.next();
    System.out.println(city.getName());       
}            
   Torbalar veriye erişim için List<T>, Set<T>, SortedSet<T>, Map<K,V> gibi arayüzler üzerinden iyi bir soyutlama sunar. Hangi torba kullanılırsa kullanılsın veriye aynı şekilde erişilir: eleman eklemek için add()/put() metodu, silmek için ise remove() metodu çağırılır. Bazı işlemler, torbadaki tüm verilere erişimi gerektirir. Örneğin, torbadaki en büyük ve en küçük değerlerin bulunması ya da ortalama hesabı gibi işlemler için torbadaki tüm verilere erişmek gerekir. Eğer bu işlem, yukarıda (1)’de ve (2)’de tanıtılan for-each ve Iterator<T> kullanılarak gerçekleştirilirse, seri olarak yürütülür. (1) ve (2) ile gerçekleştirilen döngü, döngü kurma işlemi torbanın dışında gerçekleştiği için dış döngü olarak adlandırılmaktadır. Dış döngünün bazı yitimleri vardır. En önemli yitim, çok şekilli (=polymorphic) çözümler kuramıyor olmamızdır. Seri çözümde işlem süresi, özellikle çok elemanlı torbalarda uzar. Daha hızlı sonuç almak için paralel bir çözüm tasarlamak gerekir. Java'da Callable iplikler ve ExecutorService kullanarak ve torbadaki verileri bu ipliklere (=Thread) dağıtarak paralel programlama yapmak mümkündür. Ancak yarış durumu yaratmadan ve ölümcül kilitlenme oluşturmadan yüksek başarımlı bir çözüme ulaşmak her zaman kolay değildir. Üstelik bu çözümün testini yapmak oldukça zordur. Java 8, torbalar üzerinde seri ya da paralel olarak gerçekleştirilecek işlemler için kodlama ve test süresini çok kısaltacak yenilikler sunuyor. Bu yeniliklerin bir kısmı dil seviyesinde, bir kısmı API seviyesinde ve bir kısmı da Java Sanal Makinası seviyesindedir.
   Java 8 ile birlikte yeni bir anlayışa (=Paradigm) kavuştuk: Fonksiyonel programlama. Java’da bir fonksiyona parametre olarak bir değer geçilebilir. Bu değer bir temel tipten olabileceği gibi bir nesne referansı da olabilir:
List<City> findAllCitiesByCountry(Country country){
 . . .
}
Yukarıdaki örnekte findAllCitiesByCountry fonksiyonu Country tipinden bir nesnenin referansını parametre olarak almaktadır. Benzer şekilde List<City> tipinden de bir değer dönmektedir. Fonksiyonel programlama ile birlikte fonksiyonlar parametre olarak, değer dışında fonksiyon da alabilirler veya fonksiyon da döndürebilirler. Bu şekilde parametre olarak fonksiyon alan ya da fonksiyon döndüren fonksiyonları yüksek dereceden fonksiyon (high-order functions,  bazen functional ya da functor) olarak adlandırıyoruz.
   Java 8’de torbalar üzerinde iç döngü oluşturabiliriz:
List < City > allCities = worldDao.findAllCities();
allCities.forEach(
  new Consumer < City > () {
      @Override
      public void accept(City city) {
        System.out.println(city.getName());
      }
  }
);
Dikkat edilirse Collection arayüzünde artık yeni bir metod yer alıyor: forEach(). forEach() ile iç döngü oluşturabilir. Fonksiyona parametre olarak Consumer<City> tipinden anonim sınıftan bir nesne gönderdik. forEach torbadaki her bir nesne için parametre olarak verdiğimiz anonim nesnenin accept() fonksiyonunu çağırır. Şimdi önce Consumer<T> arayüzünün tanımına bir bakalım:
@FunctionalInterface
public interface Consumer<T> {
  void accept(T t);
    default Consumer<T> andThen(Consumer<? super T> after) {
        Objects.requireNonNull(after);
        return (T t) -> { accept(t); after.accept(t); };
    }
}
Bu tanımda bizim için Java 8 ile birlikte gelen iki önemli yenilik yer alıyor:
1.  Fonksiyonel Arayüz (=Functional Interface)
Bir arayüz içinde sadece tek bir fonksiyon bulunuyorsa bu tür arayüzler fonksiyonel arayüz olarak isimlendirilir. Java 8’de bu tür arayüzleri betimlemek üzere @FunctionaInterface isimli damga kullanılır. Bu tür arayüzlere örnek olarak Runnable, Callable, Comparator, Comparable arayüzleri verilebilir. @FunctionaInterface damgasının tanımı ise aşağıda verilmiştir:
@Documented
@Retention(RetentionPolicy.RUNTIME)
@Target(ElementType.TYPE)
public @interface FunctionalInterface {}
2    2. default tanımlı varsayılan metod
default anahtar kelimesi yeni değil, ancak buradaki kullanımı yeni. Java 8’de API seviyesinde yenilik yapılırken aynı zamanda geriye doğru uyumluluğu da sağlayabilmek için arayüzlerde gövdesi tanımlanan somut fonksiyon yazılabilmesine olanak sağlanmıştır. Arayüzler, hizmet alan ve hizmet veren sınıf arasında birer sözleşme olarak düşünebilir. Sözleşmeye yeni bir metod eklendiğinde kod kırılacaktır. Varsayılan metodlar, arayüze yeni bir metod eklenirken, kodun kırılmasını engeller. Arayüzü gerçekleyen sınıf, eklenen yeni metoda işlev yüklememiş ise varsayılan metod tanımı kullanılır. Ancak bunun C++’dan bildiğimiz yan etkileri bulunmaktadır. Bu nedenle, varsayılan metodların yukarıda anlatılan amaca yönelik olarak kullanımına dikkat edilmelidir.
Fonksiyonel programlamada kısa süreli kullanıma sahip anonim fonksiyonlar l ifadesi olarak adlandırılır. Java 8’da l ifadesi oluşturulabilir. Yukarıda torba üzerinde oluşturduğumuz iç döngüyü l ifadesi olarak da yazabiliriz:
List<City> allCities=worldDao.findAllCities();
allCities.forEach( 
     (final City city) -> {      
        System.out.println(city); 
     }
);

Burada (final City city) ile l ifadesinin parametre listesini veriyoruz. l ifadesinin gövdesini ise metod gövdelerini tanımlarken kullandığımız kıvırcık parantezlerden yararlanıyoruz. Her l ifadesi mutlaka bir fonksiyonel arayüze bağlıdır, bu arayüz üzerinden tanımlanır. Ancak bizim doğrudan arayüzü belirtmemize gerek yoktur. Bu örnekte fonksiyonel arayüz Consumer<T> arayüzüdür. l ifadesinin gövdesine ise fonksiyonel arayüzün biricik metodu üzerinden erişilecektir. Fonksiyonel programlama dillerinde l ifadelerinin uygulamanın durumunu değiştirmezler. for-each ile oluşturulan dış döngüde olduğu gibi torbada değişikliğe neden olamazlar. Yukarıdaki l ifadesinde parametrenin final tanımlanmasındaki amaç budur. Ancak Java 8’deki  l ifadelerinde final kullanımı zorunlu değildir.  
Java 7 ile birlikte derleyici daha akıllı davranmaya başladı. Burada l ifadesini tanımlarken parametrenin tipini söylememize gerek yok, derleyici çıkarsama yapabilir:
List<City> allCities=worldDao.findAllCities();
allCities.forEach( 
     (city) -> {      
        System.out.println(city); 
     }
);
Ancak burada tipi çıkarsama işini derleyiciye bıraktığımızda, artık parametre final tanımlı değildir.
Eğer l ifadesi tek bir parametre alıyor ise parantez çiftini de kullanmaya gerek yoktur:
List<City> allCities=worldDao.findAllCities();
allCities.forEach( 
     city -> {      
        System.out.println(city); 
     }
);
Eğer l ifadesinin gövdesi tek bir ifadeden oluşuyor ise kıvırcık parantez çifti kullanılmayabilir:
List<City> allCities=worldDao.findAllCities();
allCities.forEach( city -> System.out.println(city) );
Eğer l ifadesi sadece bir metod çağrısından oluşuyorsa Java 8 ile birlikte gelen metod tutacağı ile ifade edilebilir:
allCities.forEach( System.out::println );
l ifadeleri ve metod tutacağı Java 8’de fonksiyonel programlama yapmak için temel yapı taşlarını oluşturur. 
Java 8 ile birlikte yukarıda tanıtıldığı gibi iç döngüler oluşturabiliyoruz. Bunu sağlayan Stream API’dır ve bunun ilk uygulamasını da Collection API’de görüyoruz. Ancak Collection API’deki kullanımına geçmeden önce Stream API’nin ne işe yaradığını gösterir bir örnek inceleyelim:
int lost[]={42,23,16,15,8,4};
IntStream.of(lost).sorted().forEach(System.out::println);
OptionalDouble average= IntStream.of(lost).average();
average.ifPresent(System.out::println);
System.out.println("Sum: "+IntStream.of(lost).sum());
Yukarıdaki kodu çalıştırdığımızda ekranda aşağıdaki çıktıyı elde ediyoruz:
4
8
15
16
23
42
18.0
Sum: 108
Stream bir iş hattı gibi düşünülebilir. Yukarıdaki kodda kullanılan IntStream sınıfı ise özel bir Stream sınıfı: iş hattından sadece tam sayılar akıyor. Bu tam sayılar akarken yapılacak işleri bir metod zinciri olarak verebiliyoruz: sorted().forEach(System.out::println). Önce sıralamasını ve sonra ekrana yazmasını istiyoruz. IntStream.of(lost).average() satırında ise akan sayıların ortalamasını hesaplamak istiyoruz. average metodu doğrudan double bir değer dönmek yerine OptionalDouble sınıfından bir değer dönüyor. Java 8’de ile gelen Optional<T> sınıflarının amacı NullPointerException oluşmasını engellemektir. average.ifPresent(System.out::println) ifadesi hiçbir zaman NullPointerException’a neden olmaz.
Şimdi torbalar üzerinde Stream API’yi kullanımını çeşitli örnekler üzerinden çalışalım.
1.  Elimizde filmlerin olduğu bir liste var ve bu liste içinden 70’li yıllara ait Drama türünde filmlere ulaşmak istiyoruz:
MovieService movieService= InMemoryMovieService.getInstance();
Collection<Movie> allMovies= movieService.findAllMovies();
Predicate<Movie> _70s= m -> m.getYear()>=1970 && m.getYear()<1980;
Predicate<Movie> drama= 
    movie -> movie.getGenres().stream()
             .filter(genre -> genre.getName().equals("Drama"))
             .count()==1;
 
// 70’li yıllara ait drama türünde filmlerin listesi
allMovies.stream().filter(_70s.and(drama)).forEach(System.err::println);
// 70’li yıllara ait sadece drama türünden filmlerin listesi
Predicate<Movie> drama_only= 
   movie -> movie.getGenres().size()==1 
   &&   
   movie.getGenres().get(0).getName().equals("Drama");
allMovies.stream().filter(_70s.and(drama_only))
                  .forEach(System.err::println);
Uygulama çalıştırıldığında ekran görüntüsü aşağıdaki gibi gerçekleşmektedir:
70's movies whose genre is Drama
Movie [title=Dog Day Afternoon, year=1975]
Movie [title=Network, year=1976]
Movie [title=The Little Girl Who Lives Down the Lane, year=1976]
Movie [title=Der amerikanische Freund, year=1977]
Movie [title=The Last Wave, year=1977]
70's movies whose genre is only Drama
Movie [title=Network, year=1976]

2. Filmleri yıllara göre ve daha sonra aynı yıllara ait filmleri kendi içinde sözlük sırasına göre listelemek istiyoruz:
MovieService movieService= InMemoryMovieService.getInstance();
Collection<Movie> allMovies= movieService.findAllMovies();
Comparator<Movie> byYear= (left,right) -> left.getYear() - right.getYear() ;
Comparator<Movie> byTitle= 
             (left,right) -> left.getTitle().compareTo(right.getTitle()) ;
allMovies.stream().sorted(byYear.thenComparing(byTitle))
                  .forEach(System.err::println);
Uygulama çalıştırıldığında ekran görüntüsü aşağıdaki gibi gerçekleşmektedir:
Movie [title=The Return of Frank James, year=1940]
Movie [title=Double Indemnity, year=1944]
Movie [title=The Treasure of the Sierra Madre, year=1948]
Movie [title=Sunset Blvd., year=1950]
Movie [title=A Streetcar Named Desire, year=1951]
Movie [title=Stalag 17, year=1953]
Movie [title=Dial M for Murder, year=1954]
Movie [title=Shichinin no samurai, year=1954]
Movie [title=Them!, year=1954]
Movie [title=Vertigo, year=1958]
. . .
Movie [title=The Book of Eli, year=2010]
Movie [title=The Bounty Hunter, year=2010]
Movie [title=Unthinkable, year=2010]
Movie [title=Veda, year=2010]
Movie [title=Yip Man 2: Chung si chuen kei, year=2010]
Movie [title=You Dont Know Jack, year=2010]
3. Birden fazla yönetmeni olan filmleri listelemek istiyoruz:
Consumer<Movie> printNamesAndNumberOfDirectors= 
 movie -> System.err.println(String.format("Title: %-36s # of directors: %d", 
          movie.getTitle(),
          movie.getDirectors().size())) ;
Predicate<Movie> multiDirectedMovies= 
       movie -> movie.getDirectors().size()>1;
allMovies.stream().filter(multiDirectedMovies)
                  .forEach(printNamesAndNumberOfDirectors);
Uygulama çalıştırıldığında ekran görüntüsü aşağıdaki gibi gerçekleşmektedir:
Title: Gamer                                # of directors: 2
Title: A Serious Man                        # of directors: 2
Title: Rembetiko                            # of directors: 2
Title: New York, I Love You                 # of directors: 2
Title: Daybreakers                          # of directors: 2
Title: The Imaginarium of Doctor Parnassus  # of directors: 2
Title: Cloudy with a Chance of Meatballs    # of directors: 2
Title: The Princess and the Frog            # of directors: 2
Title: Karamazovi                           # of directors: 2
Title: The Missing Person                   # of directors: 2
Title: Sonbahar                             # of directors: 2
Title: I Love You Phillip Morris            # of directors: 2
Title: The Book of Eli                      # of directors: 2
4.  Birden fazla yönetmeni olan filmlerin sadece yönetmenlerinin adlarını listelemek istiyoruz:
Consumer<Director> printDirectorName= 
       director -> System.err.println(director.getName()); 
Consumer<List<Director>> printDirectorNames= 
       directors -> directors.stream().forEach(printDirectorName); 
Function<Movie,List<Director>> directorMapper= 
       movie -> movie.getDirectors() ;
allMovies.stream().filter(multiDirectedMovies).map(directorMapper).forEach(printDirectorNames);
Uygulama çalıştırıldığında ekran görüntüsü aşağıdaki gibi gerçekleşmektedir:
Mark Neveldine
Brian Taylor
Ethan Coen
Joel Coen
. . .
Glenn Ficarra
John Requa
Albert Hughes
Allen Hughes
5.  Elimizde tüm dünya ülkelerinin olduğu bir liste var ve kıtaların listesini ekrana sözlük sırasına göre sıralı yazmak istiyoruz:
WorldDao worldDao= InMemoryWorldDao.getInstance();
List<String> continents= 
        worldDao.findAllCountries()
                .stream()
                .map(Country::getContinent)
                .distinct()
                .sorted(String::compareTo)
                .collect(ArrayList::new,ArrayList::add,ArrayList::addAll);
continents.forEach(System.out::println);
Uygulama çalıştırıldığında ekran görüntüsü aşağıdaki gibi gerçekleşmektedir:
Africa
Antarctica
Asia
Europe
North America
Oceania
South America
6. Nüfusu en kalabalık olan ülkeyi bulmak istiyoruz:
Comparator<Country> byPopulation=
        (left,right) -> left.getPopulation()>=right.getPopulation() ? +1 : -1 ;
Optional<Country> overPopulatedCountry= 
        worldDao.findAllCountries()
                .stream()
                .max(byPopulation);
overPopulatedCountry.ifPresent(System.out::println);
Uygulama çalıştırıldığında ekran görüntüsü aşağıdaki gibi gerçekleşmektedir:
Country [code=CHN, name=China, continent=Asia, surfaceArea=9572900.0, population=1277558000, . . . ] 
7. Nüfusu en kalabalık ilk 10 ülkeyi bulmak istiyoruz:
Comparator<Country> byPopulation = 
        (left, right) -> left.getPopulation() >= right.getPopulation() ? -1 : +1;
List<Country> overPopulatedCountries
        = worldDao.findAllCountries()
        .stream()
        .sorted(byPopulation)
        .limit(10)
        .collect(ArrayList::new, ArrayList::add, ArrayList::addAll);
overPopulatedCountries.forEach(System.out::println);
Uygulama çalıştırıldığında ekran görüntüsü aşağıdaki gibi gerçekleşmektedir:
Country [ name=China, population=1277558000]
Country [ name=India, population=1013662000]
Country [ name=United States, population=278357000]
Country [ name=Indonesia, population=212107000]
Country [ name=Brazil, population=170115000]
Country [ name=Pakistan, population=156483000]
Country [ name=Russian Federation, population=146934000]
Country [ name=Bangladesh, population=129155000]
Country [ name=Japan, population=126714000]
Country [ name=Nigeria, population=111506000]

8. Ülkeleri kıtalara göre gruplamak ve her kıtada kaç ülke olduğunu ekrana yazmak istiyoruz:
WorldDao worldDao = InMemoryWorldDao.getInstance();
Map<String,List<Country>> countriesByContinent= worldDao.findAllCountries()
        .stream()
        .collect(Collectors.groupingBy(Country::getContinent));
countriesByContinent.forEach( (key , value) ->  
System.out.println(key + ": " + value.size()));
Uygulama çalıştırıldığında ekran görüntüsü aşağıdaki gibi gerçekleşmektedir:
South America: 14
Asia: 51
Europe: 46
Africa: 58
Antarctica: 5
North America: 37
Oceania: 28
9. Film türlerinin her birinden kaç film olduğunu ekrana yazdırmak istiyoruz:
public static void main(String[] args) {
    MovieService movieService = InMemoryMovieService.getInstance();
    Collection<Movie> allMovies = movieService.findAllMovies();
    Map<String, List<Movie>> moviesByGenre
            = allMovies.stream()
            .flatMap(movie -> movie.getGenres()
                    .stream()
                    .map(genre -> pair(genre.getName(), movie)))
            .collect(groupingBy(Entry::getKey,mapping(Entry::getValue,toList())));
    moviesByGenre.forEach( (key,value) -> System.out.println(key+": "+value.size() ));
}

private static <T, U> AbstractMap.SimpleEntry<T, U> pair(T t, U u) {
    return new AbstractMap.SimpleEntry<T, U>(t, u);
}
Uygulama çalıştırıldığında ekran görüntüsü aşağıdaki gibi gerçekleşmektedir:
Film-Noir: 2
Action: 36
Adventure: 26
Horror: 19
War: 18
Romance: 56
History: 12
Western: 7
Documentary: 1
Sport: 3
Sci-Fi: 15
Drama: 180
Thriller: 70
Music: 7
Crime: 41
Fantasy: 14
Biography: 20
Family: 12
Animation: 9
Mystery: 33
Comedy: 60
Musical: 2
Yukarıdaki tüm çözümleri kolaylıkla paralelleştirebiliriz. İlk olarak yapılması gereken paralel Stream yaratmaktır. Bunun için Collection arayüzündeki parallelStream() çağrısı kullanılır:
Comparator<Country> byPopulation
        = (left, right) -> left.getPopulation() >= right.getPopulation() ? -1 : +1;
List<Country> overPopulatedCountries
        = worldDao.findAllCountries()
        .parallelStream()
.sorted(byPopulation)
        .limit(10)
        .collect(ArrayList::new, ArrayList::add, ArrayList::addAll);
Burada dikkat edilmesi gerek en önemli nokta collect çağrısının üçüncü parametresidir. Paralel Stream kullanıldığı durumda çekirdek sayısı kadar iş hattı yaratılır ve her bir çekirdek torbada kendisine düşen kısımda çalışır ve sonuçlar en son birleştirilir. Birleştirilirken ArrayList::addAll metodu kullanılır. Bu teker teker eklemeye göre daha yüksek başarım verir.
Eğer torba üzerinde kümeleme işlemi yapılıyorsa, bu durumda kümeleme işleminin paralel olan versiyonu kullanılmalıdır. Örneğin, dokuzuncu problemde kümeleme olarak Collectors.groupingBy() metodu kullanılmıştır. Aynı problem, paralel olarak çözülmek istenirse, groupingBy metodu yerine groupingByConcurrent() metodu kullanılmalıdır:

private static <T, U> AbstractMap.SimpleEntry<T, U> pair(T t, U u) {
    return new AbstractMap.SimpleEntry<T, U>(t, u);
}

public static void main(String[] args) {
    MovieService movieService = InMemoryMovieService.getInstance();
    Collection<Movie> allMovies = movieService.findAllMovies();
    Map<String, List<Movie>> moviesByGenre
            = allMovies.parallelStream()
            .flatMap(movie -> movie.getGenres()
                             .stream().map(genre -> pair(genre.getName(), movie)))
            .collect(groupingByConcurrent(Entry::getKey, 
mapping(Entry::getValue, toList())));
    moviesByGenre.forEach((key, value) -> System.out.println(key + ": " + value.size()));
}

Eğer Eclipse Luna SR1 geliştirme aracını kullanıyorsanız, 8 ve 9 ile verilen kod için derleme hatası verecektir. Eclipse kendi derleyicisini kullanır: Eclipse Compiler for Java (ECJ). Ne yazık ki javac'ın derlediği kod için ECJ hata veriyor:
Exception in thread "main" java.lang.Error: Unresolved compilation problems:
Type mismatch: cannot convert from Map<Object,List<Object>> to Map<String,List<Movie>>
 The type Map.Entry does not define getKey(Object) that is applicable here
 The type Map.Entry does not define getValue(Object) that is applicable here
Bu hatanın Eclipse'in ilerleyen sürümlerinde düzeltilmesini umuyoruz. Kodun tamamına bu bağlantıdan NetBeans projesi olarak erişebilirsiniz.
Java 8 ile ilgili daha yoğun ve detay bilgi edinmek isterseniz bu bağlantıdaki eğitimleri incelemenizi öneririm. 
View Binnur Kurt's profile on LinkedIn

Monday, September 22, 2014

İşletim Sistemleri

"İşletim Sistemleri" başlıklı kitabımın kalan bölümlerini yakın zamanda tamamlamayı planlıyorum. Yayınlanan bölümlerin içerisinde eksiklikler bulunabilir. İlerleyen iterasyonlarda hem eksik bölümleri hem de yayınlanan bölümlerdeki eksiklikleri gidermeye çalışacağım. İçerikte hem teorik konulara hem de C/C++11 ve Java 8'de ve 9'da yazılmış örnek uygulamalara yer verdim. Başta yazım hataları olmak üzere önerilerinizi ve geri bildirimlerinizi bu e-posta adresi üzerinden yapabilirsiniz.

İçindekiler
  1. İşletim Sistemi
  2. Kabuk
  3. Prosesler
  4. İplikler
  5. İplikler Arası Eş Zamanlama
  6. Prosesler Arası İletişim
  7. İş Sıralama
  8. Prosesler Arası Eş zamanlama
  9. Bellek Yönetimi
10. Dosya Sistemi
11. Soket Haberleşme

Tuesday, September 16, 2014

Java 8'deki MapReduce Çatısının Başarımının C++11 ile Karşılaştırılması

Java SE 8 ile gelen yenilikler ile birlikte artık C++11 ile Java 8'in karşılaştırılabilir konuma geldiğini söyleyebiliriz. C++11 ve Java 8 artık her ikisi de birer fonksiyonel programlama yapabildiğimiz dillere dönüştüler. C++11 ile nihayet Thread tabanlı programlama dilin parçası haline geldi. Java'nın en güçlü yönü Java programlama dili değil, Java platformudur. Yazılımın başarımını etkileyen bir çok farklı etmen bulunur: yazılımın mimarisi, donanım, işletim sistemi. Java'nın öğündüğü "bir kere yaz her yerde çalışsın" söylemi Hotspot sayesinde gerçekleşir. Her yerde çalışır ama aynı başarımda değil. Örneğin Hotspot'un Linux platformlarda Windows işletim sistemine göre daha yüksek başarım sergilediğini biliyoruz. Hotspot'un en güçlü yönü, çalışma zamanında, Java derleyicisinin bytecode'a dönüştürdüğü ikili kodu üzerinde çalıştığı işlemcinin doğrudan çalıştırabileceği doğal makina kodlarına dönüştürebilmesidir. Bunu yaparken çeşitli iyileştirmeler de yapar. Bu iyileştirmelerin bir listesi için bu adrese göz atabilirsiniz. Hotspot'un içinde basit bir profiler yer alır ve çalışan uygulamanın şeklini almasını bekler ve aldığı şekle uygun en iyilemeler yapar. Hatta bu en iyilemeleri bazen şartlar artık geçerli olmadığı için geriye aldığı da olur. Buna karşılık C++'da derleyicinin yapabildiği iyileştirmeler derleme aşamasında gerçekleşir ve bu nedenle kısıtlıdır. Eğer GNU derleyici kullanıyorsanız iyileştirmeleri en üst düzeyde açmak için -O3 seçeneğini vermeniz gerekir.
Bu yazıda C++11'in dil özellikleri ile Java 8'in dil özellikleri karşılaştırılmayacaktır. Bunun yerine, büyükçe bir dizinin elemanlarının toplamını hesaplamak gibi basit problemi her iki dilde de paralel olarak çözmeye çalışarak başarımı karşılaştırılacaktır. Her iki dilde de karşılaştırma yapabilecek yetkinliğe sahip olduğum söylenebilir.
Önce C++11 ile başlayalım:
#include <iostream>
#include <thread>
#include <future>
#include <algorithm>

using namespace std;

const int SIZE=80000000;
int numbers[SIZE];

template <typename iter>
void init_problem(iter beg,iter end){
    int i=1;
 for (iter p=beg;p!=end;p++,++i)
     *p= i;
}

template <typename iter>
int parallel_sum(iter begin, iter end){
    long len= distance(begin,end);
    if (len <= 10000000){
    return accumulate(begin,end,int()); 
 }  
    iter mid= begin + len /2;
    auto handle_left= 
    async(launch::async,parallel_sum<iter>,begin,mid);   
    auto handle_right= 
    async(launch::async,parallel_sum<iter>,mid,end);   
    return handle_left.get()+
        handle_right.get();
}

int main(){
 init_problem(numbers,numbers+SIZE);
 int sum= parallel_sum(numbers,numbers+SIZE);
 cout << "Sum (parallel): " << sum << endl ; 
}
Kodda karşılaştığınız auto, async, future C++11 ile gelen yenilikler. Kodda üretken programlamanın (=Generic Programming) gücü hissediliyor. Aynı testi std::vector ile kodda neredeyse hiçbir değişiklik yapmadan gerçekleştirebiliriz. Ama iş paralel programlamaya gelince hala alt düzey yapıları kullanmamız gerekiyor. Bu problemde gerekmedi ama barrier, semaphore gibi yapılar hazır gelmiyor. Bizim mutex yada atomic değişkenler kullanarak bu yapıları gerçekleştirmemiz bekleniyor.
Yukarıdaki kodu derlemek için GNU C++ derleyicisi kullanıldı:

g++ -lpthread -O3 -std=c++11 -o parsum parsum.cpp

Şimdi aynı problemi Java 8'de MapReduce çatısını kullanarak çözelim:

public class ParallelSum {

    private static final int SIZE = 80_000_000;
    private static int numbers[] = new int[SIZE];

    private static void init_problem(int[] array) {
        for (int i = 0, j = 1; i < array.length; ++i, ++j) {
            array[i] = j;
        }
    }

    public static void solve() {
        int sum= Arrays.stream(numbers).parallel().sum();
        System.err.println("Sum (parallel): " + sum );        
    }

    public static void main(String[] args) {
        init_problem(numbers);
        for (int i=0;i<100;++i)
            solve();
    }
}
Java 8'de çözüm aslında tek satırdan oluşuyor: int sum= Arrays.stream(numbers).parallel().sum();
Şimdi başarımları karşılaştırabiliriz. Çalışma sürelerine bakalım. Her iki uygulama da 10 defa çalıştırıldı ve süreler milisaniye hassasiyetinde ölçüldü. 4 çekirdekli 8 sanal işlemcili makinada başarım aşağıdaki şekilde gerçekleşti:
C++11 Java 8
0.018948 0.155995
0.01986 0.01995
0.022167 0.019785
0.020191 0.018711
0.020895 0.019071
0.020394 0.018406
0.021172 0.019326
0.019818 0.019334
0.020595 0.019033
0.021555 0.019154

Karşılaştırmayı daha kolay yapabilmek için aşağıdaki grafikten  yararlanabilirsiniz:


Burada JIT derleyicinin iyi iş çıkardığını görüyoruz: çalışma süresini 0.15 saniyeden 0.019 saniyeye düşürüyor. Yinelemelerde işlem sürelerinin başa baş gittiğini görüyoruz. Kodları karşılaştırdığımızda, bu durumun, Java 8 ve Hotspot için bir zafer olduğunu söyleyebiliriz. 
View Binnur Kurt's profile on LinkedIn

Java 8'in Çok Çekirdekli Programlama Başarımı

Java 8'in, Mart 2014'de duyurulmasının ardından 6 ay geçti. Şu an JDK'nın en güncel sürümü 8u20. Artık platform olgunlaşmaya başladı. Başarımı test etmenin tam zamanı. Java 8 ile pek çok yenilik ile tanıştık. Detaylar için bu makaleye göz atmanızda fayda var. Java 8'deki yeniliklerin ortak hedefi, çok çekirdekli platformlarda yüksek başarım elde etmek. Uygulama başarımı tek boyutlu bir büyüklük olarak ölçülemez. Birim zamanda çıkarılan iş, yanıt süresi, bellek ayak izi gibi birden fazla ölçüte bakmak gerekebilir. Üstelik bu ölçütler arasında bir ödünleşim (=trade-off) de vardır. Hepsini birden iyileştirmek mümkün olmayabilir.  Bu yazıda, Java 8 platformu üzerinde veri paralelliği farklı yöntemlerle gerçeklenecek ve karşılaştırması yapılacaktır. Temel olarak üç farklı yöntem izlenecektir:
I. Callable İplikler (=Threads), Future ve Executor Kullanımı
Runnable ipliklerin en kötü yönü run() metodunun herhangi bir parametre alamaması ve ipliğin bir değer döndürememesidir. Bu yüzden görevi yaratan iplik ile sonucu üretecek iplik arasında mutlaka bir senkronizasyon kurmak gerekir. Java SE 5 ile gelen Callable arayüzü ile artık sonucu call() metodundan dönmek ve Future arayüzünün get() çağrısı ile bu sonuca asenkron bir şekilde ulaşmak mümkündür. Java SE 5 ile gelen yeniliklerden biri de İplik havuzudur (=Thread Pool). Farklı havuz türleri ihtiyaca göre seçilebilir: Her zaman  sabit sayıda ipliğin yer aldığı Fixed Thread Pool, Parlamalı çalışma modu için Cached Thread Pool, Yığın işler için Single Thread Pool, Periyodik işler için Scheduled Thread Pool. Ancak buradaki tüm yapılar alt düzeydedir. Bu yüzden bu yapı üzerinde uygulama geliştirmek vakit alır, test etmesi zordur, yarış durumları (=race conditions) ve ölümcül kilitlenme (=deadlock) gibi durumların iyi düşünülmüş olması gerekir.
II. Fork/Join Çatısısnın (=Framework) Kullanımı
Java SE 7 ile gelen Fork/Join çatısı temelde İş Çalma (=Work Stealing) algoritmasına dayanır. Java 7'deki Fork/Join çatısı kullanımına ilişkin detayları bu yazıdan okuyabilirsiniz. Fork/Join çatısı I'e göre kodlaması daha kolay olsa da hala alt düzey bir API sunmaktadır. Üstelik problemi iki alt parçaya ayırmak ile seri olarak çözümü arasında genellikle veri boyutu üzerinden verilmesi gereken bir karar vardır.
III. Dönüştür-İndirge (=Map-Reduce) Çatısının Kullanımı
Dönüştür-İndirge çatısı Java SE 8 ile gelmiştir ve alt tarafta Fork/Join çatısını kullanır. Collection API ile hazır olarak gelen paralel kaplar ve Dönüştür-İndirge çerçevesi kullanılarak, çekirdek sayısına göre ölçeklenebilir çözümlere hızlıca ulaşabilir.

Örnek Problemin Tanımı

Karşılaştırmada seçilen problem uzayını tanıyalım:
public class Programmer implements Serializable {

    private int id;
    private String name;
    private String surname;
    private int age;
    private ProgrammingLanguage programmingLanguage;
    . . .
}

public class ProgrammingLanguage implements Serializable {

    private String name;
    private int level;
    . . .
}

Önce 60 milyon Programmer sınıfından rastgele nesne yaratıp bir ArrayList'in içine atıyoruz. Amacımız bu listenin içinden 40 yaşın üstünde "en bilgili" Java programcısını bulmak. Bunun için yukarıda tanımladığımız üç yaklaşımı da kullanacağız ve süreleri karşılaştıracağız.

Seri Çözüm

Çözümün doğruluğunu sınamak ve hızlanmayı karşılaştırabilmek için problemi seri olarak çözmek uygun olur:

private static long serialSolve(List<Programmer> list) {
        long start = System.nanoTime();
        Programmer oldest = null;
        for (Programmer programmer : list) {
            if (programmer.getAge() > 40 && programmer.getProgrammingLanguage().getName().equalsIgnoreCase("java")) {
                if (oldest == null) {
                    oldest = programmer;
                } else if (programmer.getProgrammingLanguage().getLevel() > oldest.getProgrammingLanguage().getLevel()) {
                    oldest = programmer;
                }
            }
        }
        System.err.println("Oldest [Serial]: " + oldest);
        long stop = System.nanoTime();
        return (stop - start);
    }

Callable İplik ve Future Kullanımı

private static long parallelSolveCallableThread(List<Programmer> list) throws InterruptedException {
        long start = System.nanoTime();
        Programmer oldest = null;
        int numberOfSegments = DATA_SIZE / SERIAL_THRESHOLD;
        ExecutorService es = Executors.newFixedThreadPool(Runtime.getRuntime().availableProcessors());
        List<Callable<Programmer>> callables = new ArrayList<>(numberOfSegments);
        for (int i = 0, j = 0; i < numberOfSegments; ++i, j += SERIAL_THRESHOLD) {
            callables.add(new ProcessingThread(j, SERIAL_THRESHOLD, list));
        }
        List<Future<Programmer>> partialSolutions = es.invokeAll(callables);

        try {
            oldest = partialSolutions.get(0).get();
            for (int i = 1; i < partialSolutions.size(); ++i) {
                Programmer programmer = partialSolutions.get(i).get();
                if (programmer.getProgrammingLanguage().getLevel() > oldest.getProgrammingLanguage().getLevel()) {
                    oldest = programmer;
                }
            }
        } catch (InterruptedException | ExecutionException ex) {
            Logger.getLogger(PerformanceTest.class.getName()).log(Level.SEVERE, null, ex);
        }
        System.err.println("Oldest [Callable Thread]: " + oldest);
        long stop = System.nanoTime();
        es.shutdown();
        return (stop - start);
    }

public class ProcessingThread implements Callable<Programmer> {

    private final int start;
    private final int length;
    private final List<Programmer> list;

    public ProcessingThread(int start, int length, List<Programmer> list) {
        this.start = start;
        this.length = length;
        this.list = list;
    }

    @Override
    public Programmer call() throws Exception {
        Programmer oldest = list.get(start);
        Programmer programmer;
        for (int i = start + 1, j = 1; j < length; ++j, ++i) {
            programmer = list.get(i);
            if (programmer.getAge() > 40 && programmer.getProgrammingLanguage().getName().equalsIgnoreCase("java")) {
                if (programmer.getProgrammingLanguage().getLevel() > oldest.getProgrammingLanguage().getLevel()) {
                    oldest = programmer;
                }
            }
        }
        return oldest;
    }

}

Fork/Join Çatısının Kullanımı

private static long parallelSolveForkJoin(List<Programmer> list) {
        long start = System.nanoTime();
        ForkJoinPool pool = new ForkJoinPool();
        ForkListProcessing flp = new ForkListProcessing(0, list.size(), list);
        Programmer oldest = pool.invoke(flp);
        System.err.println("Oldest [FJ]: " + oldest);
        long stop = System.nanoTime();
        return (stop - start);
    }

public class ForkListProcessing extends RecursiveTask<Programmer> {

    private final int start;
    private final int length;
    private final List<Programmer> list;
    private static final int SERIAL_THRESHOLD = 5_000_000;

    public ForkListProcessing(int start, int length, List<Programmer> list) {
        this.start = start;
        this.length = length;
        this.list = list;
    }

    @Override
    public Programmer compute() {
        if (length <= SERIAL_THRESHOLD) {
            return serialSolver();
        } else {
            int startLeft = start;
            int lengthLeft = length / 2;
            int startRight = start + lengthLeft;
            int lengthRight = length - lengthLeft;
            RecursiveTask<Programmer> left = new ForkListProcessing(startLeft, lengthLeft, list);
            RecursiveTask<Programmer> right = new ForkListProcessing(startRight, lengthRight, list);
            left.fork();
            right.fork();
            Programmer leftSolution = left.join();
            Programmer rightSolution = right.join();
            if (leftSolution.getProgrammingLanguage().getLevel() >= rightSolution.getProgrammingLanguage().getLevel()) {
                return leftSolution;
            } else {
                return rightSolution;
            }
        }
    }

    private Programmer serialSolver() {
        Programmer oldest = list.get(start);
        Programmer programmer;
        for (int i = start + 1, j = 1; j < length; ++j, ++i) {
            programmer = list.get(i);
            if (programmer.getAge() > 40 && programmer.getProgrammingLanguage().getName().equalsIgnoreCase("java")) {
                if (programmer.getProgrammingLanguage().getLevel() > oldest.getProgrammingLanguage().getLevel()) {
                    oldest = programmer;
                }
            }
        }
        return oldest;
    }

}


Dönüştür-İndirge Çatısının Kullanımı

private static long parallelSolveMapReduce(List<Programmer> list) {
        long start = System.nanoTime();
        Programmer oldest = list.parallelStream()
                .filter((Programmer prg) -> prg.getAge() > 40 && prg.getProgrammingLanguage().getName().equalsIgnoreCase("java"))
                .reduce((left, right) -> left.getProgrammingLanguage().getLevel() >= right.getProgrammingLanguage().getLevel() ? left : right).get();

        System.err.println("Oldest [MapReduce]: " + oldest);
        long stop = System.nanoTime();
        return (stop - start);
    }

Deneysel Sonuçlar

Örnek uygulama 4 fiziksel çekirdeğin ve 8 sanal işlemcinin olduğu i7 işlemcili bir dizüstü bilgisayarda (Asus N56VZ-S4255H), Hotspot Java Sanal Makinası üzerinde koşturulmuştur. Kullanılan Hotspot parametreleri aşağıdaki gibidir: -Xms5096m -Xmx6096m -XX:+UseG1GC -Xcomp.
Sürelerin yer aldığı tabloyu aşağıda izleyebilirsiniz:
Serial Fork/Join Map-Reduce Callable Thread
2668505068 287335266 2944504598 371450954
1520665434 256402330 220530644 297969676
1466104840 248664714 216625912 344167024
1464082558 253262636 218372802 298162542
1516772250 255020642 239981168 302813920
1524937500 248614678 214424022 298976328
1466208756 248644184 213896322 371450954
1465564738 250441532 213332274 299036198
1478366830 384069164 211912956 299329982
1459489336 248061746 211580254 295550550
Tablodaki değerler yöntemin aldığı süreyi nano saniye biriminde vermektedir. Her bir satır yinelemeyi göstermektedir. Her bir yöntem 10 defa yinelenerek tekrar çalıştırılmıştır. Karşılaştırmayı daha kolay yapabilmek için aşağıdaki grafikten  yararlanabilirsiniz:
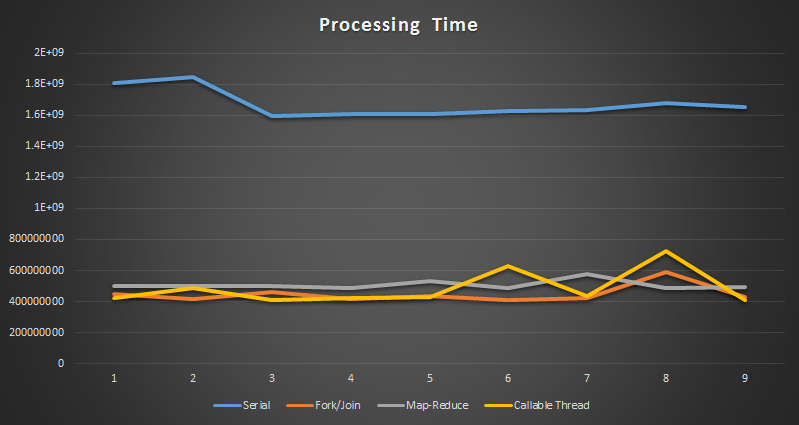
Aynı uygulamanın i7 işlemcili 2 fiziksel çekirdeği 4 sanal işlemcisi bulunan Samsung ultrabook (NP-900X4C)'daki başarımı aşağıdaki gibi gerçekleşmiştir:
Serial Fork/Join Map-Reduce Callable Thread
19741743117 580408617 4701616707 626018473
1806017710 448612143 496646177 424259928
1848274359 417033783 502213371 484369695
1597769920 462913357 499692308 408970979
1610160940 416298935 486345985 423605953
1606404182 435899678 534527811 426688621
1625213014 408824009 486342701 626018473
1632420684 422062362 576433047 435159082
1680902197 592661288 489187262 724467204
1653464440 430231904 493916565 406734823
Yukarıdaki tabloyu daha kolay yorumlayabilmek için aşağıdaki grafikten yararlanabilirsiniz:

En iyi sonucu 8 sanal işlemcili makinada Map-Reduce ile 4 sanal işlemcili makinada Callable Thread kullanarak elde ediyoruz. Genel olarak sonuçların biri birine çok yakın olduğunu söyleyebiliriz. Map-Reduce'un farkını daha yüksek çekirdek sayılarında görebiliriz. Map-Reduce ile elde edilen en önemli kazanç geliştirme süresinin kısa olması, testinin ve bakımının kolay olmasıdır. Çözüm yaklaşık 10 satırlık bir kod parçasından oluşmaktadır. Burada Callable Thread ve Fork/Join çözümleri özellikle en iyilenmemiştir, ortalama başarımları karşılaştırılmaya çalışılmıştır. Kodun tamamına NetBeans projesi olarak bu adresten ulaşabilirsiniz.
View Binnur Kurt's profile on LinkedIn